如何控制 LLM 的幻觉是一直以来很难解决的问题,尤其是在长上下文的情况下,LLM 的注意力丢失和出现幻觉的概率大大增加。无论是网页版的 ChatBot 类(如 ChatGPT 旧版本、Gemini) 等,还是我们常用的 Agent 框架(如 CodeX、 opencode 等),都存在上下文窗口限制的问题。
我们一般使用的是 rolling truncation window(滑动截断窗口) 来控制模型的上下文。但是 https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/ 这篇文章中说,因为这两个特性——放弃推理和滑动截断,GPT-5.6 Sol 不仅无法记住过去的思考过程,还会丢失过去的操作记忆。
于是 OpenAI 的人们就想到了:如果可以让 Agents 来记住自己做了什么,那么它们就能发挥出最大的能力。
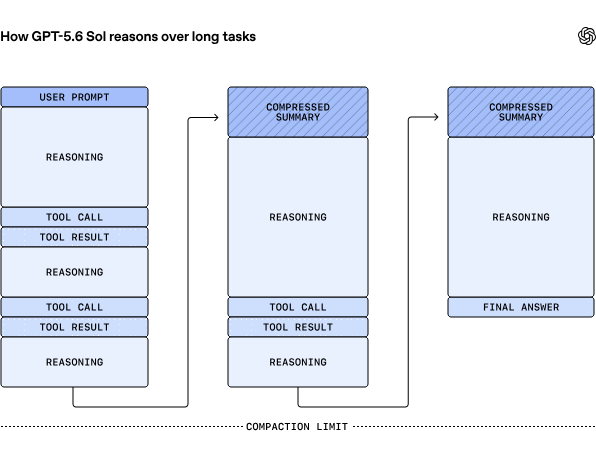
这就是模型的训练方式,也是它们在 ChatGPT 和 Codex 中的部署方式。他们使用 Responses API 实现了 ARC-AGI-3 harness。在 Responses API 中,对于 GPT-5.6,传递之前的 response ID 可以自动保留跨工具调用和回合的推理过程。
在推理能力保留的情况下,有两个值得注意的点:
-
首先,GPT-5.6 Sol 在每次行动前思考的时间减少了,因为它不再需要每回合都从头开始进行推理。
-
其次,当它能够记住过去的想法时,GPT-5.6 Sol 在学习和运用连贯策略方面表现得更好。
第二个改进就是从 滑动截断窗口 到 Compaction(压缩) 的转变。同样可以通过 Responses API 来实现。Compaction 允许模型在不丢失重要信息的情况下,压缩上下文窗口,从而提高模型的效率和性能。
结论
如果像让 LLM 记住过去的思考过程和操作记忆一样,让它们能够在上下文窗口中自动切换和压缩信息,将会极大地提高它们的推理能力和效率。
参考链接
- Anthropic - Effective context engineering for AI agents
- Anthropic - The new rules of context engineering for Claude 5
- Anthropic - A field guide to Claude Fable
- OpenAI - Harness engineering: leveraging Codex in an agent-first world
- OpenAI - Compaction(Responses API 窗口切换,含 server-side 与 /responses/compact)
- OpenAI - Reasoning models — Preserve reasoning across calls
- OpenAI - How enabling two settings tripled our scores on ARC-AGI-3
- The Missing Memory Hierarchy: Demand Paging for LLM Context Windows - Pichay
- virtual-context - Virtual Context Swapping System
- Claude Code Docs - Memory and CLAUDE.md / Skills